
本教程适用于以下操作系统版本
- Ubuntu 22.04 (Jammy Jellyfish)
- Ubuntu 18.04 (Bionic Beaver)
本页内容
- Prerequisites
- Step 1 - 配置防火墙
- Step 2 - 安装 InfluxDB
- Step 3 - 创建 InfluxDB 数据库和用户凭证
- Step 4 - 安装 Telegraf
- Step 5 - 验证 Telegraf 统计数据是否已存储到 InfluxDB
- Step 6 - 安装 Grafana
- Step 7 - 配置 Grafana 数据源
- Step 8 - 配置 Grafana 仪表盘
- Step 9 - 配置告警与通知(Conditions、Rule、No Data & Error Handling)
- Conclusion
- Conditions
- Rule
- No Data & Error Handling
TIG(Telegraf、InfluxDB 和 Grafana)Stack 是一组开源工具平台的缩写,它能让系统指标的收集、存储、绘图和告警变得更加容易。你可以从一处监控并可视化内存、磁盘空间、登录用户、系统负载、交换分区使用情况、运行时间、运行中的进程等指标。该栈中所使用的工具如下:
- Telegraf - 是一个开源的指标收集代理,用于从数据库、系统和 IoT 传感器收集和发送数据与事件。它支持各种输出插件,如 InfluxDB、Graphite、Kafka 等,可将收集到的数据发送给它们。
- InfluxDB - 是一个用 Go 语言编写的开源时序数据库。它针对快速、高可用的存储进行了优化,适用于任何涉及大量带时间戳数据的场景,包括指标、事件和实时分析。
- Grafana - 是一个开源的数据可视化和监控套件。它支持各种输入插件,如 Graphite、ElasticSearch、InfluxDB 等。它提供了美观的仪表盘和指标分析功能,让你能够可视化和监控各类系统指标及性能数据。
在本教程中,你将学习如何在单台 Ubuntu 22.04 服务器上安装并配置 TIG Stack。
Prerequisites
- 一台运行 Ubuntu 22.04 的服务器。
- 一个具有 root 权限的非 sudo 用户。
- uncomplicated Firewall(UFW)已启用并正在运行。
- 确保系统已全部更新。$ sudo apt update && sudo apt upgrade
一台运行 Ubuntu 22.04 的服务器。
一个具有 root 权限的非 sudo 用户。
uncomplicated Firewall(UFW)已启用并正在运行。
确保系统已全部更新。
$ sudo apt update && sudo apt upgrade
Step 1 - 配置防火墙
在安装任何软件包之前,第一步是配置防火墙,为 InfluxDB 和 Grafana 开放端口。
检查防火墙的状态。
$ sudo ufw status
你应该会看到类似以下内容。
Status: active

To                         Action      From
--                         ------      ----
OpenSSH                    ALLOW       Anywhere
OpenSSH (v6)               ALLOW       Anywhere (v6)
为 InfluxDB 开放端口 8086,为 Grafana 服务器开放端口 3000。
$ sudo ufw allow 8086
$ sudo ufw allow 3000
再次检查状态以确认。
$ sudo ufw status
Status: active

To                         Action      From
--                         ------      ----
OpenSSH                    ALLOW       Anywhere
8086                       ALLOW       Anywhere
3000                       ALLOW       Anywhere
OpenSSH (v6)               ALLOW       Anywhere (v6)
8086 (v6)                  ALLOW       Anywhere (v6)
3000 (v6)                  ALLOW       Anywhere (v6)
Step 2 - 安装 InfluxDB
我们将使用 InfluxDB 的官方仓库来安装它。
下载 InfluxDB 的 GPG 密钥。
$ wget -q https://repos.influxdata.com/influxdb.key
将 GPG 密钥导入服务器。
$ echo '23a1c8836f0afc5ed24e0486339d7cc8f6790b83886c4c96995b88a061c5bb5d influxdb.key' | sha256sum -c && cat influxdb.key | gpg --dearmor | sudo tee /etc/apt/trusted.gpg.d/influxdb.gpg > /dev/null
导入 InfluxDB 仓库。
$ echo 'deb [signed-by=/etc/apt/trusted.gpg.d/influxdb.gpg] https://repos.influxdata.com/debian stable main' | sudo tee /etc/apt/sources.list.d/influxdata.list
更新系统的仓库列表。
$ sudo apt update
你可以选择安装 InfluxDB 1.8.x 或 2.0.x。不过,最好使用最新版本。安装 InfluxDB。
$ sudo apt install influxdb2
启动 InfluxDB 服务。
$ sudo systemctl start influxdb
检查服务的状态。
$ sudo systemctl status influxdb
? influxdb.service - InfluxDB is an open-source, distributed, time series database
     Loaded: loaded (/lib/systemd/system/influxdb.service; enabled; vendor preset: enabled)
     Active: active (running) since Tue 2022-09-13 00:00:27 UTC; 42s ago
       Docs: https://docs.influxdata.com/influxdb/
    Process: 12514 ExecStart=/usr/lib/influxdb/scripts/influxd-systemd-start.sh (code=exited, status=0/SUCCESS)
   Main PID: 12515 (influxd)
      Tasks: 7 (limit: 1030)
     Memory: 48.5M
        CPU: 547ms
     CGroup: /system.slice/influxdb.service
             ??12515 /usr/bin/influxd
........
Step 3 - 创建 InfluxDB 数据库和用户凭证
要存储来自 Telegraf 的数据,你需要设置 Influx 数据库和用户。
InfluxDB 自带一个名为 influx 的命令行工具,用于与 InfluxDB 服务器交互。可以把 influx 看作是 mysql 命令行工具。
运行以下命令为 Influx 执行初始配置。
$ influx setup
> Welcome to InfluxDB 2.0!
? Please type your primary username navjot
? Please type your password ***************
? Please type your password again ***************
? Please type your primary organization name howtoforge
? Please type your primary bucket name tigstack
? Please type your retention period in hours, or 0 for infinite 360
? Setup with these parameters?
  Username:          navjot
  Organization:      howtoforge
  Bucket:            tigstack
  Retention Period:  360h0m0s
 Yes
User    Organization    Bucket
navjot  howtoforge      tigstack
你需要设置初始用户名、密码、组织名称、用于存储数据的主 bucket 名称,以及该数据的保留时长(小时)。你的详细信息保存在 /home/username/.influxdbv2/configs 文件中。
你也可以通过在浏览器中打开 URL http://
你应该会看到如下仪表盘。
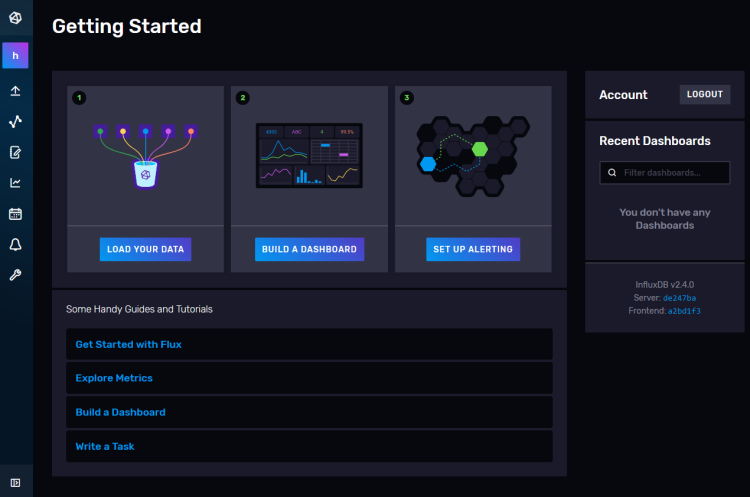
初始设置过程会创建一个默认 token,它对数据库中所有组织拥有完整的读写权限。出于安全考虑,你需要一个新 token,它只连接到我们想要连接的组织和 bucket。
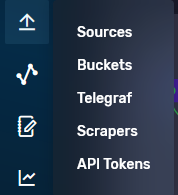
要创建一个新 token,点击左侧边栏中的以下图标,然后点击 API Tokens 链接继续。
你会进入 API Tokens 页面。在这里,你会看到我们在初始配置时创建的默认 token。
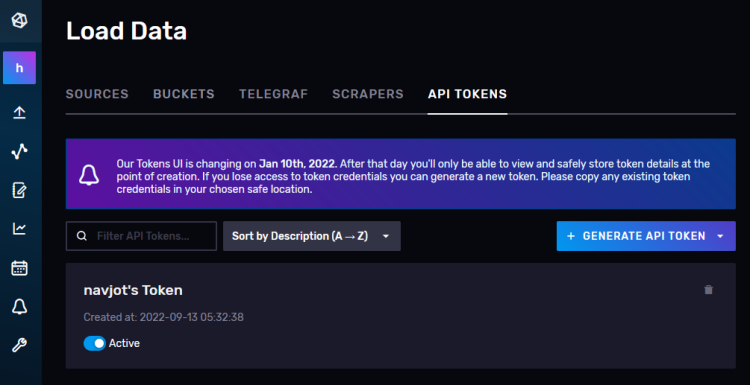
点击 Generate Token 按钮,并选择 Read/Write Token 选项,以弹出一个新的覆盖窗口。为 Token 命名(telegraf),并在 Read 和 Write 两个部分的下方都选择我们创建的默认 bucket。
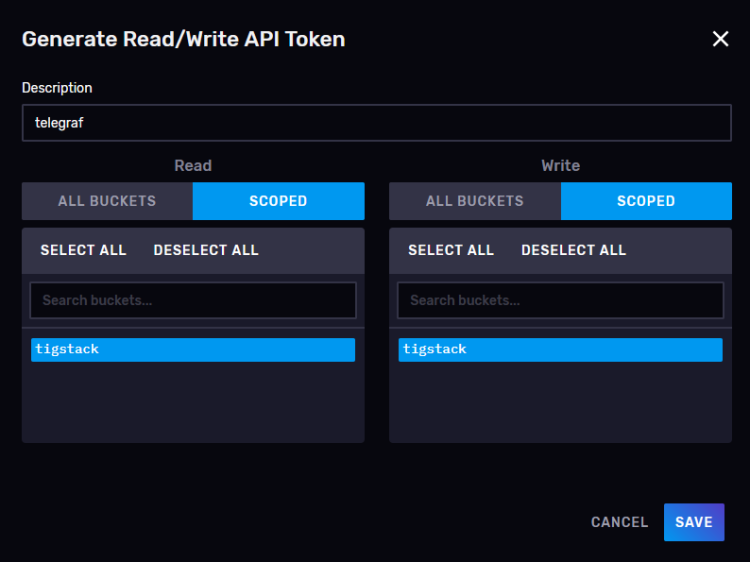
点击 Save 完成 token 的创建。点击新创建 token 的名称,以弹出一个显示 token 值的窗口。
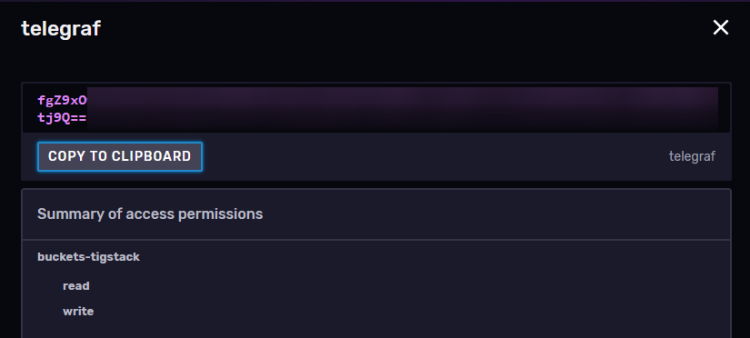
先把它保存好,因为稍后我们会用到它。
这就完成了 InfluxDB 的安装和配置。接下来,我们需要安装 Telegraf。
Step 4 - 安装 Telegraf
Telegraf 和 InfluxDB 共用同一个仓库。这意味着你可以直接安装 Telegraf。
$ sudo apt install telegraf
Telegraf 的服务在安装过程中会自动启用并启动。
Telegraf 是一个插件驱动的代理,拥有 4 种类型的插件:
- Input 插件收集指标。
- Processor 插件转换、修饰并过滤指标。
- Aggregator 插件创建并聚合指标。
- Output 插件定义指标发送的目标,包括 InfluxDB。
Telegraf 将所有这些插件的配置存储在 /etc/telegraf/telegraf.conf 文件中。第一步是通过启用 influxdb_v2 输出插件,将 Telegraf 连接到 InfluxDB。打开 /etc/telegraf/telegraf.conf 文件进行编辑。
$ sudo nano /etc/telegraf/telegraf.conf
找到 [[outputs.influxdb_v2]] 这一行,去掉前面的 # 以取消注释。按下述方式编辑其下方的代码。
# # Configuration for sending metrics to InfluxDB 2.0
 [[outputs.influxdb_v2]]
#   ## The URLs of the InfluxDB cluster nodes.
#   ##
#   ## Multiple URLs can be specified for a single cluster, only ONE of the
#   ## urls will be written to each interval.
#   ##   ex: urls = ["https://us-west-2-1.aws.cloud2.influxdata.com"]
   urls = ["http://127.0.0.1:8086"]
#
#   ## Token for authentication.
   token = "$INFLUX_TOKEN"
#
#   ## Organization is the name of the organization you wish to write to.
   organization = "howtoforge"
#
#   ## Destination bucket to write into.
   bucket = "tigstack"
将之前保存的 InfluxDB token 值粘贴到上面代码中 $INFLUX_TOKEN 变量的位置。
搜索 INPUT PLUGINS 这一行,你会看到默认启用的以下输入插件。
# Read metrics about cpu usage
[[inputs.cpu]]
  ## Whether to report per-cpu stats or not
  percpu = true
  ## Whether to report total system cpu stats or not
  totalcpu = true
  ## If true, collect raw CPU time metrics
  collect_cpu_time = false
  ## If true, compute and report the sum of all non-idle CPU states
  report_active = false
  ## If true and the info is available then add core_id and physical_id tags
  core_tags = false


# Read metrics about disk usage by mount point
[[inputs.disk]]
  ## By default stats will be gathered for all mount points.
  ## Set mount_points will restrict the stats to only the specified mount points.
  # mount_points = ["/"]

  ## Ignore mount points by filesystem type.
  ignore_fs = ["tmpfs", "devtmpfs", "devfs", "iso9660", "overlay", "aufs", "squashfs"]

  ## Ignore mount points by mount options.
  ## The 'mount' command reports options of all mounts in parathesis.
  ## Bind mounts can be ignored with the special 'bind' option.
  # ignore_mount_opts = []


# Read metrics about disk IO by device
[[inputs.diskio]]
....
....

# Get kernel statistics from /proc/stat
[[inputs.kernel]]
  # no configuration


# Read metrics about memory usage
[[inputs.mem]]
  # no configuration

# Get the number of processes and group them by status
[[inputs.processes]]
  # no configuration


# Read metrics about swap memory usage
[[inputs.swap]]
  # no configuration


# Read metrics about system load & uptime
[[inputs.system]]
  # no configuration
你可以根据需要配置额外的输入插件,包括 Apache Server、Docker containers、Elasticsearch、iptables 防火墙、Kubernetes、Memcached、MongoDB、MySQL、Nginx、PHP-fpm、Postfix、RabbitMQ、Redis、Varnish、Wireguard、PostgreSQL 等。
完成后,按 Ctrl + X 保存文件,并在提示时输入 Y。
应用完更改后,重启 Telegraf 服务。
$ sudo systemctl restart telegraf
Step 5 - 验证 Telegraf 统计数据是否已存储到 InfluxDB
在继续之前,你需要验证 Telegraf 的统计信息是否被正确收集并送入 InfluxDB。在浏览器中打开 InfluxDB 的 UI,点击左侧边栏中从左边数第三个图标,并选择 Buckets 菜单。
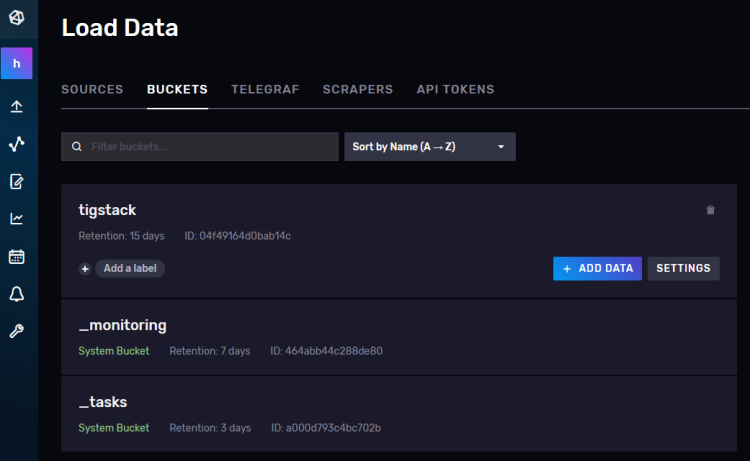
点击 tigstack,你应该会看到如下页面。
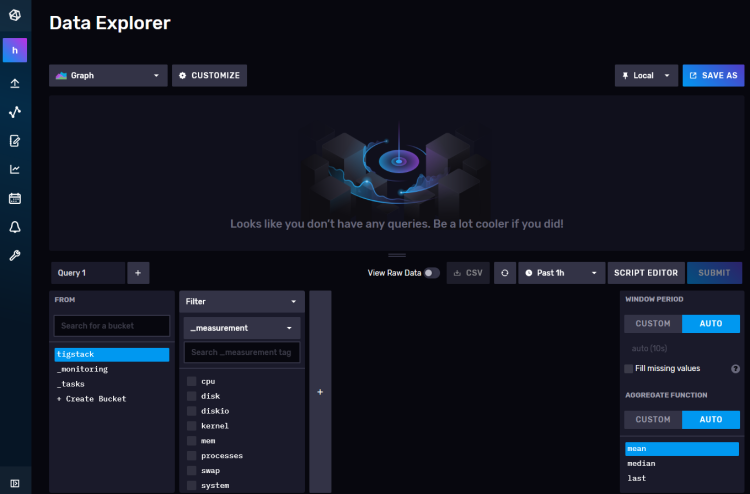
点击 bucket 名称,然后点击 _measurement 过滤器中的某个值,并在它们出现时不断点击其他值。完成后,点击 Submit 按钮。你应该在顶部看到一个图表。你可能需要等待一段时间,数据才会出现。
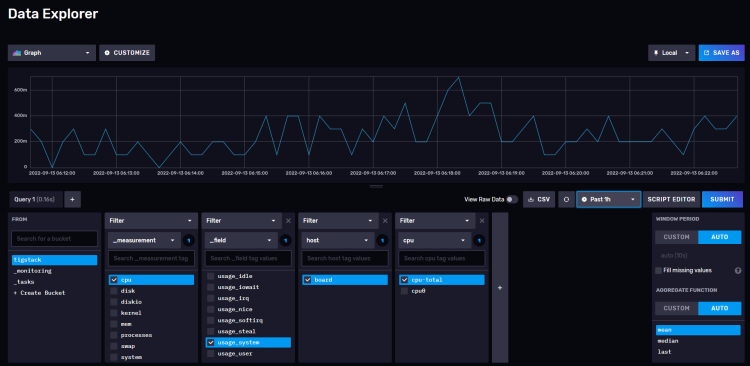
这应当能确认数据正在被正确传递。
Step 6 - 安装 Grafana
我们将使用 Grafana 的官方仓库来安装它。导入 Grafana 的 GPG 密钥。
$ sudo wget -q -O /usr/share/keyrings/grafana.key https://packages.grafana.com/gpg.key
将仓库添加到你的系统中。
$ echo "deb [signed-by=/usr/share/keyrings/grafana.key] https://packages.grafana.com/oss/deb stable main" | sudo tee -a /etc/apt/sources.list.d/grafana.list
更新系统仓库列表。
$ sudo apt update
安装 Grafana。
$ sudo apt install grafana
启动并启用 Grafana 服务。
$ sudo systemctl enable grafana-server --now
检查服务状态。
$ sudo systemctl status grafana-server
? grafana-server.service - Grafana instance
     Loaded: loaded (/lib/systemd/system/grafana-server.service; enabled; vendor preset: enabled)
     Active: active (running) since Tue 2022-09-13 01:04:47 UTC; 2s ago
       Docs: http://docs.grafana.org
   Main PID: 13674 (grafana-server)
      Tasks: 7 (limit: 1030)
     Memory: 104.6M
        CPU: 1.050s
     CGroup: /system.slice/grafana-server.service
             ??13674 /usr/sbin/grafana-server --config=/etc/grafana/grafana.ini --pidfile=/run/grafana/grafana-server.pid --packaging=deb cfg:default.paths.logs=/var/log/grafana
.......
Step 7 - 配置 Grafana 数据源
在浏览器中打开 URL http://
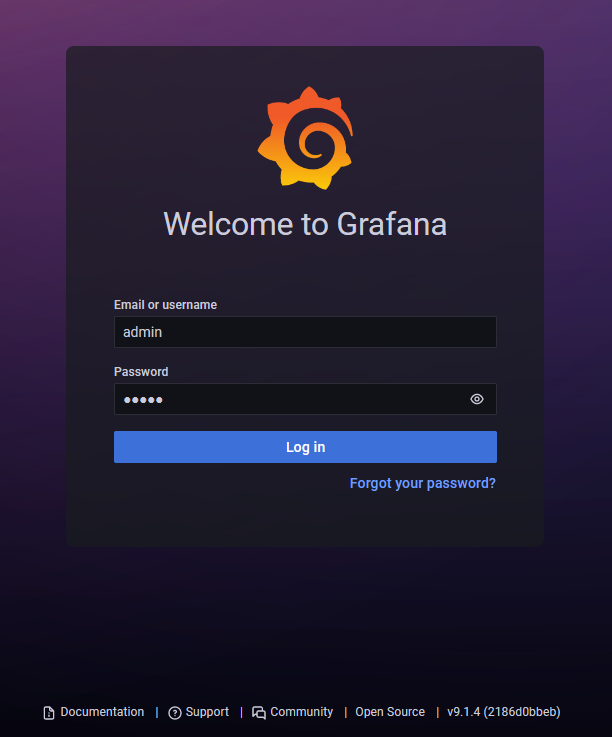
使用默认用户名 admin 和密码 admin 登录。接下来,你需要设置一个新的默认密码。
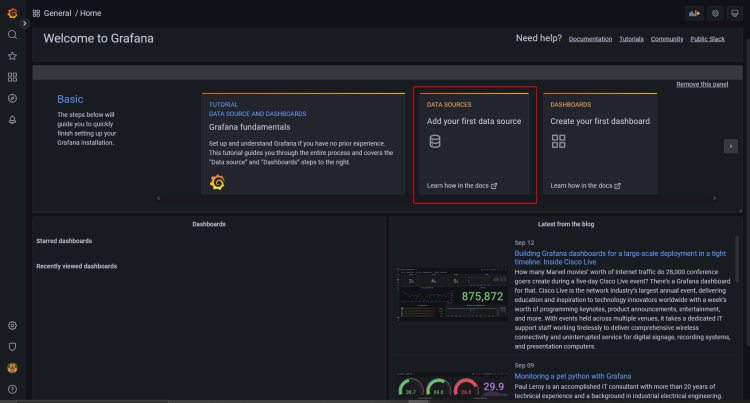
你会看到如下 Grafana 主页。点击 Add your first data source 按钮。
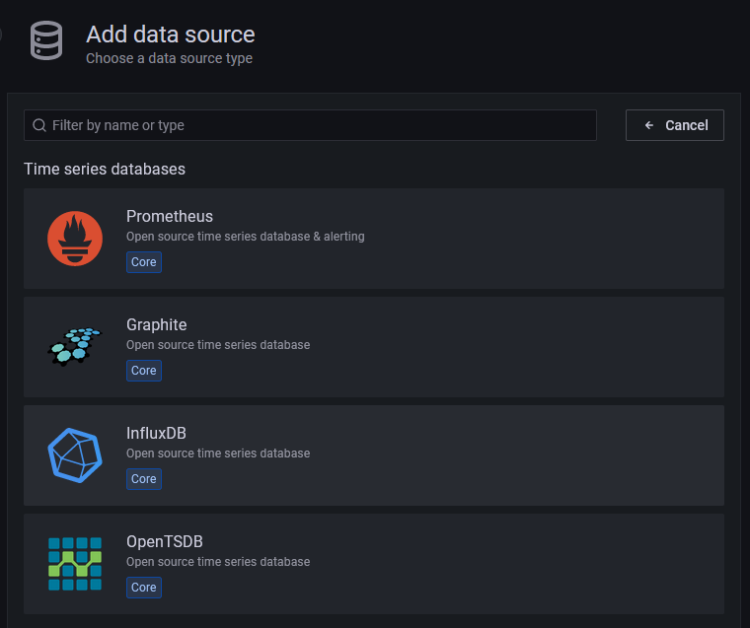
点击 InfluxDB 按钮。
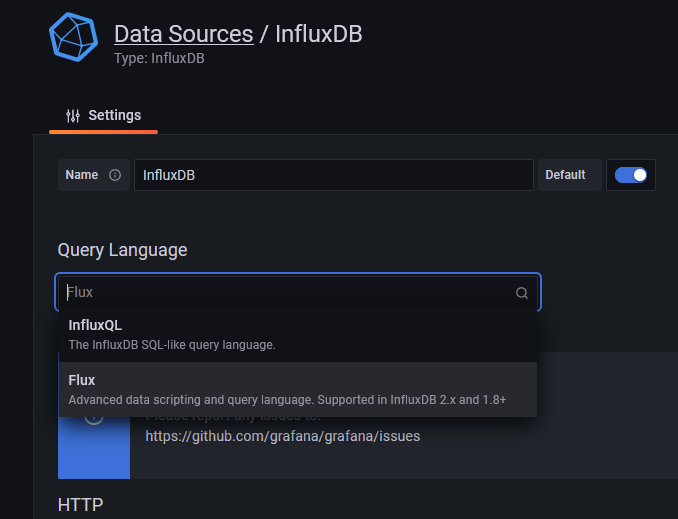
在下一页,从下拉菜单中选择 Flux 作为查询语言。你也可以使用 InfluxQL 作为查询语言,但配置起来更复杂,因为它默认只支持 InfluxDB v1.x。Flux 支持 InfluxDB v2.x,并且更容易设置和配置。
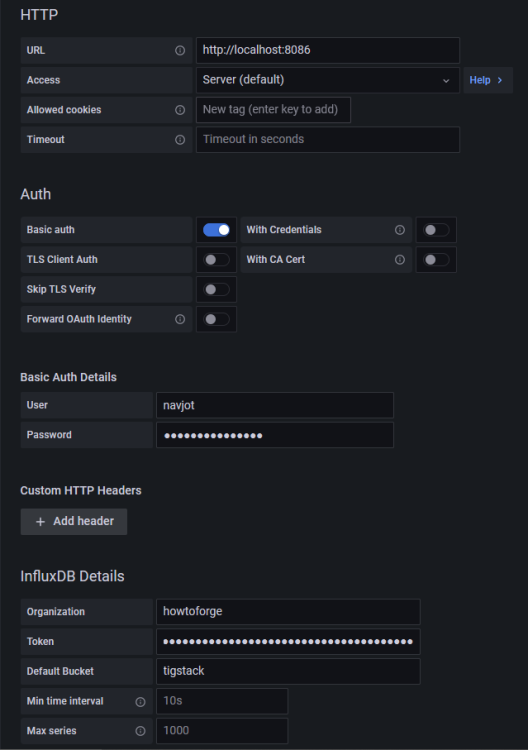
输入以下值。
URL: http://localhost:8086
Access: Server
Basic Auth Details
User: navjot
Password:
InfluxDB Details
Organization: howtoforge
Token:
Default Bucket: tigstack
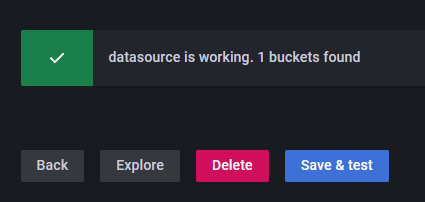
点击 Save and test 按钮,你应该会看到一条确认消息,验证设置成功。
Step 8 - 配置 Grafana 仪表盘
下一步是配置 Grafana 仪表盘。点击带有四个方块的标志,并选择 Dashboards,以打开 Dashboard Create 屏幕。
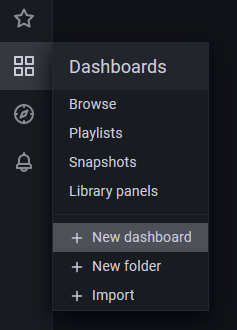
在下一页,点击 Add a new panel 按钮,以打开如下屏幕。
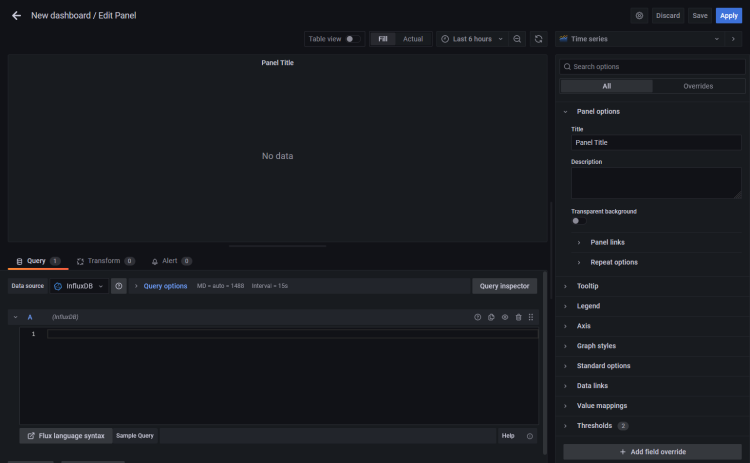
将以下代码粘贴到 Query Editor 中。这段代码
from(bucket: "NAMEOFYOUBUCKET")
  |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
  |> filter(fn: (r) => r["_measurement"] == "cpu")
  |> filter(fn: (r) => r["_field"] == "usage_idle")
  |> filter(fn: (r) => r["cpu"] == "cpu-total")
  |> filter(fn: (r) => r["host"] == "NAMEOFYOURHOST")
  |> aggregateWindow(every: v.windowPeriod, fn: mean, createEmpty: false)
  |> map(fn: (r) => ({ r with _value: r._value * -1.0 + 100.0 }))
  |> toFloat()
  |> yield(name: "mean")
使用我们上面用过的 bucket 名称,以及主机名,你可以从 /etc/hostname 文件中获取它。
上面的代码将计算 CPU 使用率并为其生成图表。给 Panel 取一个标题。
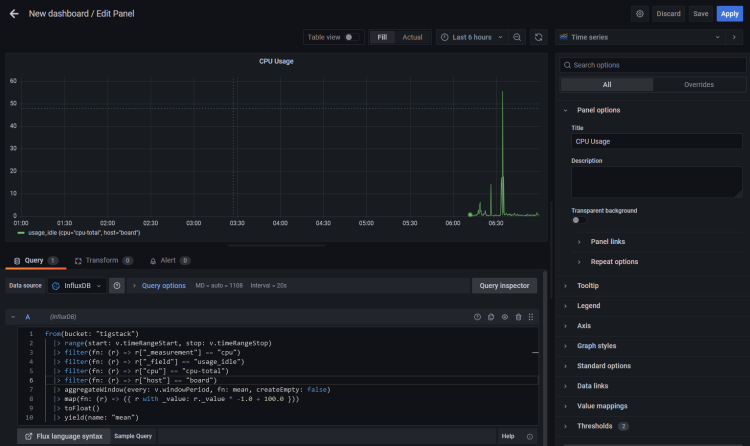
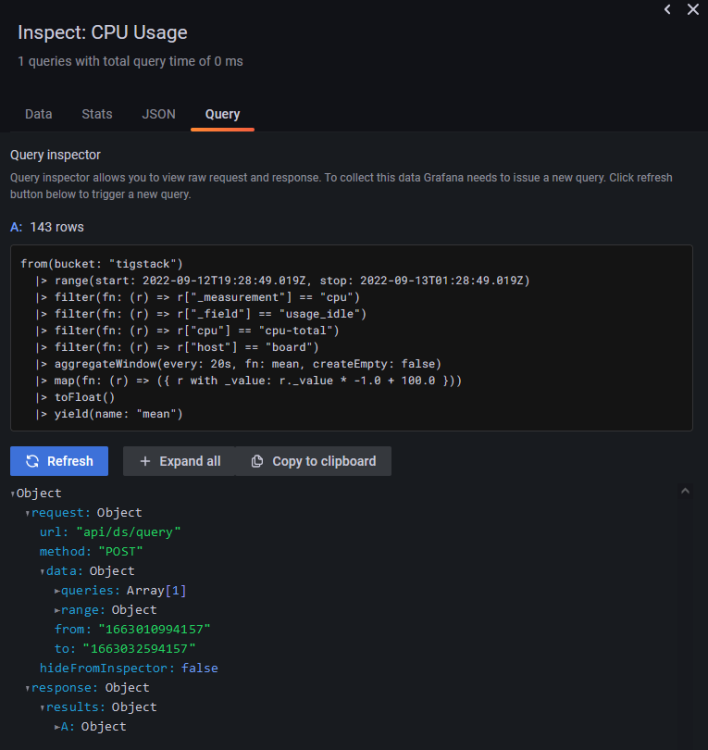
点击 Query inspector 按钮,然后点击 Refresh 按钮,以验证你的查询是否正常工作。点击叉号图标关闭 inspector。
你也可以使用右侧 Axis 部分下的 Label 字段为坐标轴命名。
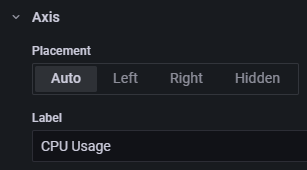
点击 Apply 按钮以保存面板。
完成后,点击 Save Dashboard 按钮。
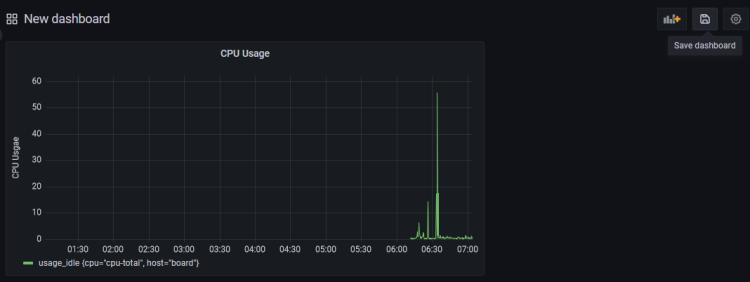
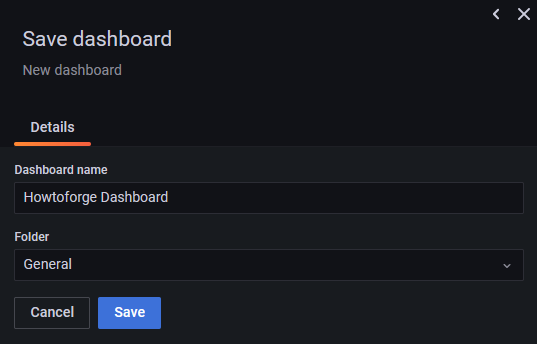
为仪表盘命名,然后点击 Save 完成。
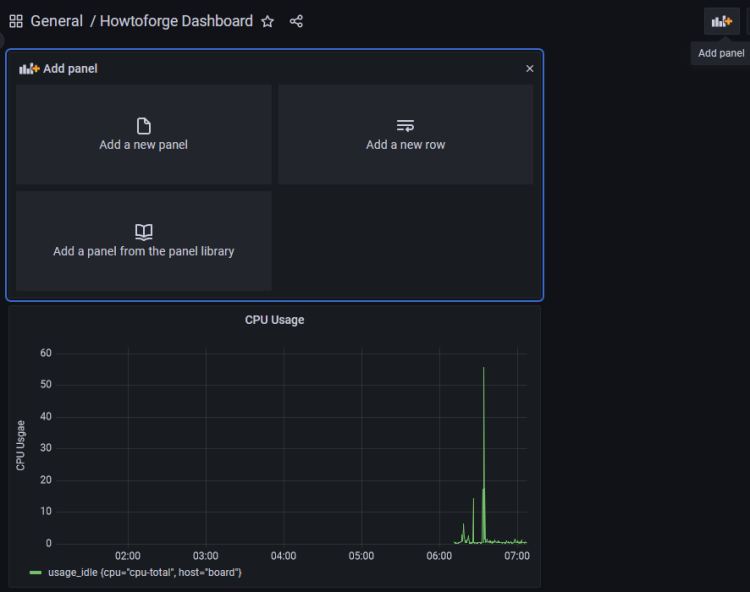
它会打开仪表盘,然后点击 Add Panel 按钮以创建另一个面板。
通过为 RAM Usage 创建另一个面板来重复此过程。
from(bucket: "NAMEOFYOUBUCKET")
  |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
  |> filter(fn: (r) => r["_measurement"] == "mem")
  |> filter(fn: (r) => r["_field"] == "used_percent")
  |> filter(fn: (r) => r["host"] == "NAMEOFYOURHOST")
  |> aggregateWindow(every: v.windowPeriod, fn: mean, createEmpty: false)
  |> yield(name: "mean")
并使用以下代码来显示 HDD Usage。
from(bucket: "NAMEOFYOURBUCKET")
  |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
  |> filter(fn: (r) => r["_measurement"] == "disk")
  |> filter(fn: (r) => r["_field"] == "used")
  |> filter(fn: (r) => r["path"] == "/")
  |> filter(fn: (r) => r["host"] == "NAMEOFYOURHOST")
  |> aggregateWindow(every: v.windowPeriod, fn: mean, createEmpty: false)
  |> map(fn: (r) => ({ r with _value: r._value / 1000000.0 }))
  |> toFloat()
  |> yield(name: "mean")
你可以创建不限数量的面板。
上面的代码基于 Flux Scripting 语言。幸运的是,你不需要学习这门语言就能编写查询。你可以从 InfluxDB 的 URL 生成查询。尽管学习这门语言有助于优化查询。
你需要回到 InfluxDB 仪表盘并打开 Explore 页面来获取查询。
点击 bucket 名称,然后点击 _measurement 过滤器中的某个值,并在它们出现时不断点击其他值。完成后,点击 Script Editor 按钮,你应该会看到如下页面。图表也应同时更新。
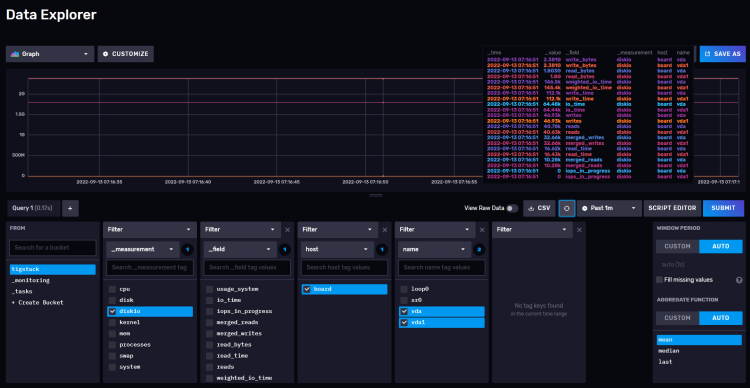
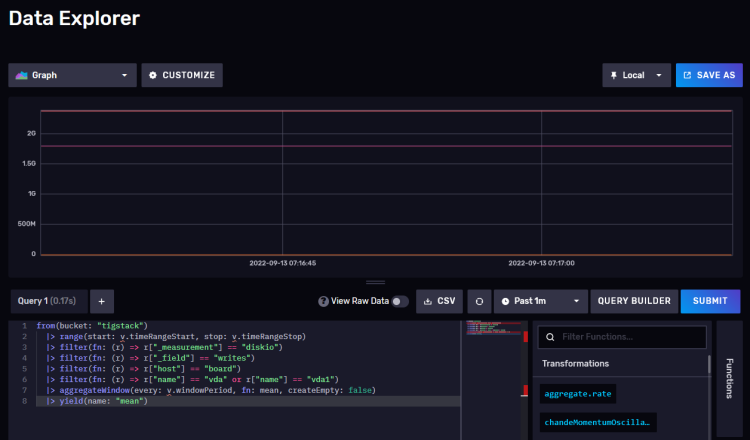
复制所显示的查询,你现在可以在 Grafana 仪表盘中使用它来构建你的图表。
Step 9 - 配置告警与通知
设置监控的主要用途是,当数值超过某个阈值时及时收到告警。
第一步是设置你想要接收告警的目标。你可以通过 Email、Slack、Kafka、Google Hangouts Chat、Microsoft Teams、Telegram 等接收通知。
在我们的教程中,我们将启用邮件通知。要设置邮件通知,我们需要先配置 SMTP 服务。打开 /etc/grafana/grafana.ini 文件来配置 SMTP。
$ sudo nano /etc/grafana/grafana.ini
在其中找到 [smtp] 这一行。取消以下各行注释,并输入自定义 SMTP 服务器的值。
[smtp]
enabled = true
host = email-smtp.us-west-2.amazonaws.com:587
user = YOURUSERNAME
# If the password contains # or ; you have to wrap it with triple quotes. Ex """#password;"""
password = YOURUSERPASSWORD
;cert_file =
;key_file =
;skip_verify = false
from_address =
[email protected]

from_name = HowtoForge Grafana
# EHLO identity in SMTP dialog (defaults to instance_name)
;ehlo_identity = dashboard.example.com
# SMTP startTLS policy (defaults to 'OpportunisticStartTLS')
;startTLS_policy = NoStartTLS
按 Ctrl + X 保存文件,并在提示时输入 Y。
重启 Grafana 服务器以应用设置。
$ sudo systemctl restart grafana-server
打开 Grafana 页面,点击 Alert 图标,然后点击 Contact points。
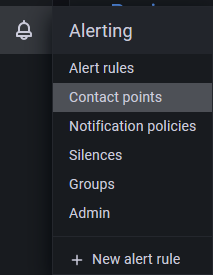
Grafana 会自动创建并设置一个默认的邮件联系点,需要为其配置正确的邮箱地址。点击 grafana-default-email 联系点旁边的 edit 按钮。
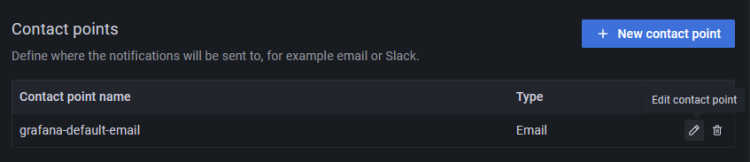
输入详细信息以设置 Email 通知渠道。
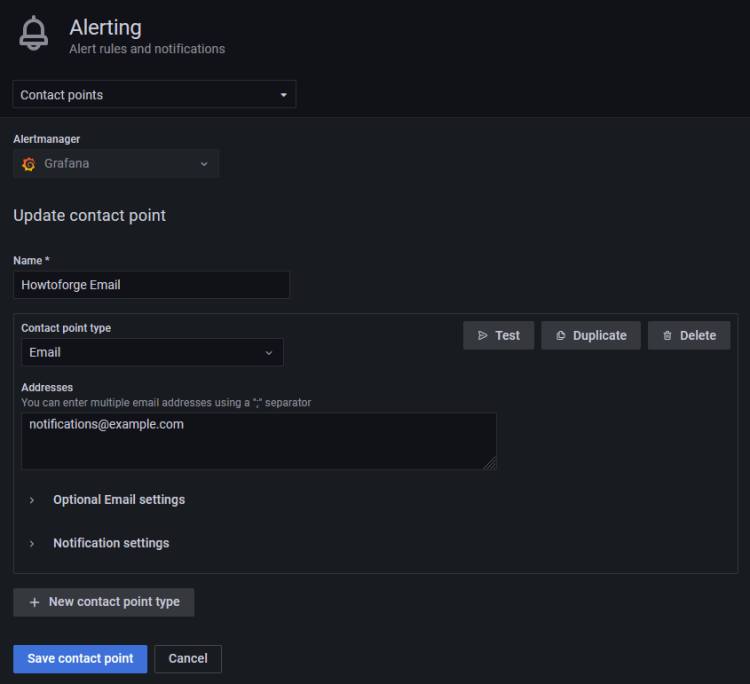
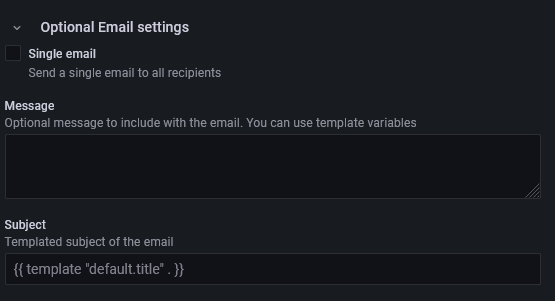
如果要发送附加消息,点击 Optional Email settings 链接并输入消息。
点击 Test 查看邮件设置是否正常工作。完成后点击 Save。
既然我们已经设置好了通知渠道,就需要设置在何时接收这些邮件的告警。要设置告警,你需要回到仪表盘面板的页面。
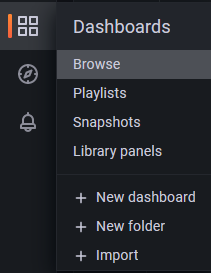
点击 Dashboard >> Browse 以打开 Dashboard 页面。
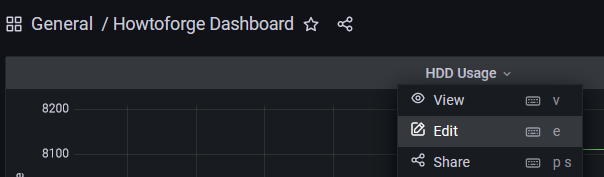
点击我们刚刚创建的仪表盘,你会看到它的主页以及不同的面板。要编辑面板,点击面板名称,会弹出一个下拉菜单。点击 Edit 链接继续。
点击 Alert Panel,然后点击 Create alert rule from this panel 按钮来设置一个新的告警。
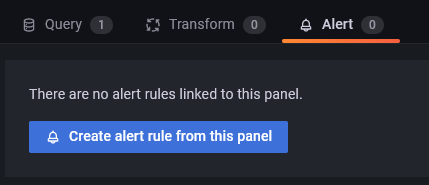
你现在可以配置 Grafana 发送告警的条件。
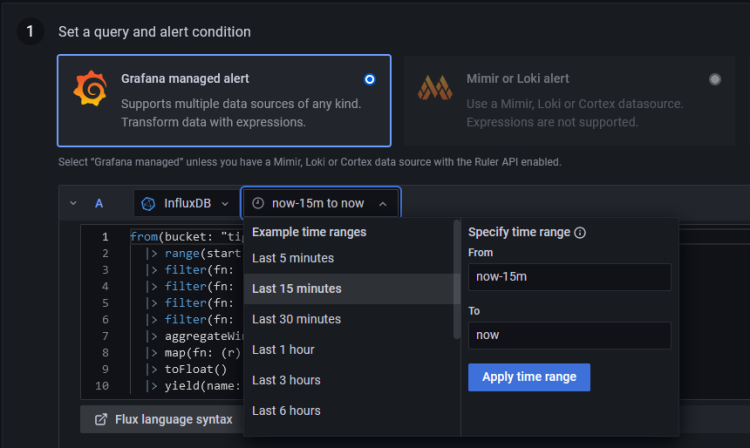
默认情况下,选中的告警类型是 Grafana 管理的告警。点击下拉菜单将时间范围改为 Last 15 minutes,这意味着它会从 15 分钟前检查到现在。
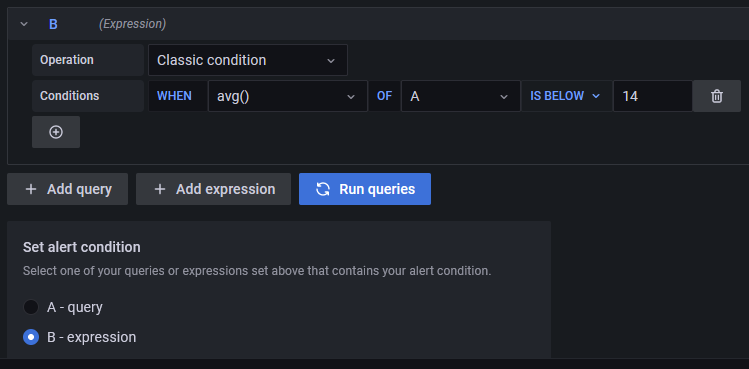
Conditions
Grafana 基于以下格式的查询来决定何时触发告警。
avg() OF query(A) IS BELOW 14
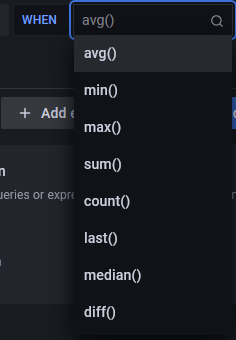
- avg() 控制如何将每个序列的值缩减为与阈值可比的值。你可以点击函数名来选择不同的函数,如 avg()、min()、max()、sum()、count() 等。
- query(A) 括号中的字母定义了要从 Metrics 选项卡执行哪个查询。
- IS BELOW 14 定义阈值的类型和阈值大小。你可以点击 IS BELOW 来选择不同的阈值类型。
query(A) 括号中的字母定义了要从 Metrics 选项卡执行哪个查询。
IS BELOW 14 定义阈值的类型和阈值大小。你可以点击 IS BELOW 来选择不同的阈值类型。
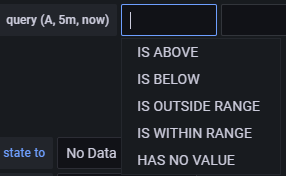
你可以通过点击第一个条件下方的 + 按钮,在它下面添加第二个条件。目前,你只能在多个条件之间使用 AND 和 OR 运算符。
Rule
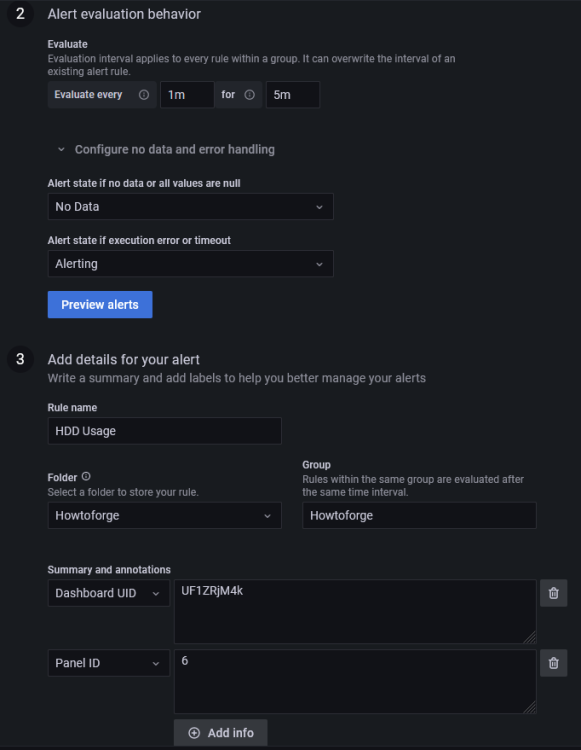
- Name - 为告警输入一个描述性名称
- Folder - 创建或选择一个已存在的文件夹来存储你的通知规则。
- Group - 为你的告警组输入一个名称。同一组中的告警会在相同的时间间隔之后进行评估。
- Evaluate every - 指定 Grafana 应多久评估一次告警。它也被称为评估间隔。你可以在此处设置任何你想要的值。
No Data & Error Handling
你可以配置 Grafana 应如何处理返回无数据或仅返回 null 值的查询,使用以下条件:
- No Data - 将规则状态设为 NoData
- Alerting - 将规则状态设为 Alerting
- Ok - 将告警规则状态设为 Ok,即即使一切正常你也会收到告警。
你可以告诉 Grafana 如何处理执行或超时错误。
- Alerting - 将规则状态设为 Alerting
- Ok - 将告警规则状态设为 Ok,即即使一切正常你也会收到告警。
- Error - 将告警规则状态设为 Error,以指示存在问题。
完成后,点击 Preview alerts 按钮查看是否一切正常。点击右上角的 Save and exit 按钮,完成告警的添加。你现在应该开始收到邮件告警了。
Conclusion
本教程关于在基于 Ubuntu 22.04 的服务器上安装和配置 TIG Stack 的内容到此结束。如果你有任何问题,请在下方评论中留言。